のべラボ.blog

Tech Blog | AWS や 生成 AI 、サーバーレス、コンテナ などなど

Codex on Bedrock や ChatGPT desktop on Bedrock を試してみる

最近、Codex や GPT-5.6、GPT-6 Astra がけっこう良いのではないかと個人的に感じ始めました。

そこで Codex や ChatGPT desktop を、ふだん自分がよく使用している Amazon Bedrock と組み合わせて使う方法を実際に試してみました。

この記事の内容は、2026年9月12日に検証した結果をベースにしています。

ちなみにこの記事は AI を使わず書いていますので、もし文章が稚拙だったらごめんなさい💦


参考情報

Codex や ChatGPT desktop を Amazon Bedrock と組み合わせて使うにあたり、下記を参考にしました。

aws.amazon.com

learn.chatgpt.com

aws.amazon.com


設定の流れ

  1. AWS アカウントの認証情報の準備
  2. Codex CLI と ChatGPT desktop のインストール
  3. .codex/config.toml に設定を追記

1. AWS アカウントの認証情報の準備

今回はサクッと簡単に試すのが目的なので、Amazon Bedrock の API キーを発行して AWS_BEARER_TOKEN_BEDROCK 環境変数 に設定することにしました。

ただ、今後本格的に使用する際は、aws login コマンドを使うことなどを検討したいと思います。

Amazon Bedrock の API キーは、短期キーと長期キーのどちらでも使用できます。

今回はひとまず短期キーを使うことにしました。このキーを環境変数に設定しますが、短期キーはキーの文字列が長いので、Windows では注意が必要です。

Windows の場合、setx コマンドだと設定できる値のサイズが 1,024 文字に切り取られます。よって短期キーの場合は setx コマンドではなく、PowerShell で以下のコマンドを実行して設定しました。

[Environment]::SetEnvironmentVariable("AWS_BEARER_TOKEN_BEDROCK", "キー値", "User")

設定後、新しい PowerShell セッションを起動して、下記のコマンドで確認します。

$env:AWS_BEARER_TOKEN_BEDROCK

なお、長期キーの場合はキーのサイズが短いので、Windows では setx コマンドで設定できます。


2. Codex CLI と ChatGPT desktop のインストール

Codex CLI のインストールは、下記のページを参考に行います。

learn.chatgpt.com

上記のページでは、macOS/Linux、Windows、npm、Homebrew でのインストール手順が記載されています。

この段階ではインストールだけを行い、起動やサインインは行いません。

ChatGPT desktop のインストールは下記のページから行います。

chatgpt.com


3. .codex/config.toml に設定を追記

.codex/config.toml ファイルの構成内容は、Codex CLI と ChatGPT desktop の両方から参照されます。

ここが一番重要な手順となりますが、さほど複雑ではありません。

Codex のインストールにより、OS のホームディレクトリに .codex/config.toml ファイルが作成されていますので、テキストエディタで開きます。

ファイルの冒頭に下記の 2行を追記します。

model = "global.openai.gpt-5.6-sol"
model_provider = "amazon-bedrock-runtime"

先に紹介したブログ記事「Accessing OpenAI models on Amazon Bedrock from Australia with global cross-Region inference」にも記載がありましたが、model_provider に amazon-bedrock-runtime を指定するのは、グローバルのクロスリージョン推論プロファイルを使用するためです。

model_provider に amazon-bedrock と指定すると、Bedrock の mantle エンドポイントを使用する設定になります。

上記 2行だけでもいいのですが、追加で Auto Review や Approval Policy、コンテキストウィンドウを設定する場合は、下記も追記します。

approval_policy = "on-request"
approvals_reviewer = "auto_review"
model_context_window = 1000000

Auto Review や Approval Policy を設定することで、一部のタスクを人の承認なしで実行できるため、より自律的な動作が期待できます

  • approval_policy = "on-request":通常作業は自動実行し、サンドボックス外操作やネットワークの利用など、承認が必要な場合にだけ承認を求めます。
  • approvals_reviewer = "auto_review":承認要求を人ではなく自動レビュー担当 AI がポリシーに基づいて判定します。

次に、ファイルの最下部に AWS リージョンを追記します。

[model_providers.amazon-bedrock-runtime.aws]
region = "ap-northeast-1"

.codex/config.toml 編集時の注意点は、[ ] で囲まれた範囲(テーブル)を適切に把握したうえで追記することです。 テーブルの設定範囲は、次のテーブルの [ ] が表示される直前までです。

デフォルトですでに多くのテーブルが設定されているので、追記する内容が誤って関係のないテーブルの範囲に含まれないようにしましょう。 そのため、modelmodel_provider などはファイルの冒頭部分に追記するのが無難です。


確認

では設定が反映されているか確認してみます。

  1. Windows の PowerShell やターミナルを起動し、任意の作業用のフォルダに移動します。

  2. codex と入力して Codex CLI を起動します。

下記は Windows での例ですが、フォルダを信頼するか尋ねられたら › 1. Yes, continue を選択して Enter キーを押下します。

  Welcome to Codex, OpenAI's command-line coding agent

> You are in C:\test0912

  Do you trust the contents of this directory? Working with untrusted contents comes with higher risk of prompt
  injection. Trusting the directory allows project-local config, hooks, and exec policies to load.

› 1. Yes, continue
  2. No, quit

  Press enter to continue
  • すると、下記のような表示になります。model に config.toml で指定したモデル ID が表示されることを確認します。
╭──────────────────────────────────────────────────────────╮
│ >_ OpenAI Codex (v0.154.0)                               │
│                                                          │
│ model:     global.openai.gpt-5.6-sol low   /model to ch… │
│ directory: C:\test0912                                   │
╰──────────────────────────────────────────────────────────╯

  Tip: New Build faster with Codex.


› Ask Codex to do anything

  global.openai.gpt-5.6-sol low · C:\test0912
  • 次に、/status コマンドを実行します。 Model provider に amazon-bedrock-runtime と表示されることを確認します。
/status

╭──────────────────────────────────────────────────────────────────────────────────╮
│  >_ OpenAI Codex (v0.154.0)                                                      │
│                                                                                  │
│  Model:                global.openai.gpt-5.6-sol (reasoning low, summaries auto) │
│  Model provider:       amazon-bedrock-runtime                                    │
│  Directory:            C:\test0912                                               │
│  Permissions:          Workspace (Approve for me)                                │
│  Agents.md:            <none>                                                    │
│  Collaboration mode:   Default                                                   │
│  Session:              01a093c1-c564-7ef3-8c9e-e4ee446f44c1                      │
│                                                                                  │
│  Token usage:          0 total  (0 input + 0 output)                             │
│  Context window:       100% left (0 used / 1M)                                   │
│  Limits:               data not available yet                                    │
╰──────────────────────────────────────────────────────────────────────────────────╯


› Ask Codex to do anything

  global.openai.gpt-5.6-sol low · C:\test0912
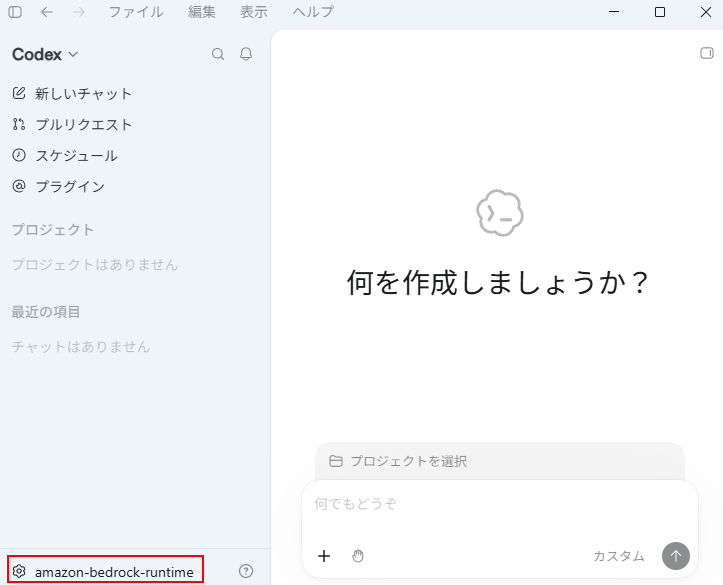
  • 次に、ChatGPT desktop アプリにアクセスします。 左下にモデルプロバイダーとして指定した amazon-bedrock-runtime と表示されることを確認します。


所感

参考にしたブログ記事やドキュメントにも記載があるように、Codex や ChatGPT desktop を Amazon Bedrock と組み合わせて使う場合、設定はそれほど複雑ではないという印象です。 config.toml の編集時、typo があった場合は Codex CLI や ChatGPT desktop の起動時に、誤りのある行や内容を示すエラーが表示されるのも役立ちました。 ただ、前述のように TOML ファイルの [ ] の範囲、つまりテーブルの範囲だけは意識しておきましょう。

これで Codex と ChatGPT desktop を Amazon Bedrock と組み合わせて使用できるようになりました!

これからいろいろ触って試してみます!


Strands Agents SDK のマルチエージェント(Workflow / Graph / Swarm)を試してみた

仕事上、これまで生成 AI の基礎学習のトレーニングや、Amazon Bedrock の API を使用してシンプルな生成 AI アプリケーションを構築するトレーニングを数多く実施してきましたが、最近では「AI エージェント」に関するトレーニングを実施する機会が増えてきました。 そのため、Kiro や Amazon Quick、Claude Code などの完成形の AI エージェントを使いこなすためのカリキュラムや、AI エージェントそのものを構築するカリキュラムを数多く検討しています。

その中で、AI エージェントの構築というトピックにおいては、「マルチエージェントの設計」というところが最近では無視できなくなってきたと感じています。

これまでは「いかに(単体の)エージェントを構築するか」という観点だけにフォーカスしてきましたが、本格的な AI エージェントの環境を実装する上では、どのような役割分担で、どのように複数のエージェントを連携させるか、という観点も必要になります。

マルチエージェントの技術や設計・実装には様々なものがありますが、今回は Strands Agents SDK のドキュメントに記載されている 3つのマルチエージェントのパターン(Workflow / Graph / Swarm)にもとづきサンプルを作成してそれぞれの違いをまとめていきます。

strandsagents.com

なお、この記事に記載している内容は、2026年8月に検証した結果に基づいています。


マルチエージェントとは / 3 パターンの位置づけ

まず、マルチエージェントシステムとは何かを簡単に整理しておきます。

これは、1 つのエージェントだけでは複雑すぎたり大きすぎたりするタスクを、複数の自律的なエージェントが協力して解決するための仕組みです。Strands Agents SDK の公式ドキュメントでは、その要点として次の 3 つが挙げられています。

要点 内容
オーケストレーション(Orchestration) エージェント間の情報やタスクの流れを管理する制御構造
専門化(Specialization) 各エージェントが特定の役割・専門性と、使えるツールを持つこと
協調(Collaboration) エージェント同士が情報を共有し、互いの成果を踏まえて作業を進めること

そして Strands Agents SDK では、このオーケストレーションのやり方として Workflow / Graph / Swarm という 3 つのパターンが用意されています。

この 3 つ、名前だけ見ると「どれも複数エージェントを動かすもの」で似ているように感じますが、一番の違いは「実行の経路(次にどのエージェントが動くか)を誰が決めるのか」 という点にあります。ここさえ押さえておけば、3 つのパターンの使い分けはかなりスッキリ理解できると思います。

パターン 経路を決めるのは 内容
Workflow 開発者 実行する順番をコードで固定します
Graph 開発者 ノード(エージェント)とエッジ(依存関係)で経路を定義します
Swarm エージェント自身 次に誰へ渡すかを自律的に判断します(ハンドオフ)

重要な区別:3 つは「同じ立ち位置」ではない

ここで、もう 1 つ押さえておきたい大事な点があります。それは、この 3 つは SDK での提供のされ方が違う ということです。私も最初は「3 つとも SDK の機能なんだろう」と思っていたのですが、公式ドキュメントを読むと、実はそうではありませんでした。

  • Graph と Swarm は、SDK 本体(strands パッケージ)が提供する 組み込みのオーケストレーターです。公式ドキュメントでも "built-in SDK orchestrators" と表現されており、strands.multiagent から GraphBuilderSwarm をインポートすれば、実行制御や状態共有、ハンドオフといった面倒な部分を SDK が担ってくれます。
  • 一方で Workflow は、専用のオーケストレーターがあるわけではなく、エージェントをコードで連結して自分で実装する「設計パターン」 です。公式ドキュメントでも "a pattern you implement in code by chaining agents together" と説明されています。

つまり「Strands Agents SDK のマルチエージェント機能」と一括りにされがちですが、Graph・Swarm は SDK の機能そのもの、Workflow はコードで組む設計パターン、という違いがあるわけですね。

なお、Workflow については、strands-agents-toolsstrands_tools)パッケージに、タスクの依存解決や並列実行を自動化してくれる workflow ツールも用意されています。今回のサンプルでは、パターンの本質を理解しやすいように、あえて素の Agent をコードで連結する方式にしています。

3 パターンの比較

ここまでの内容を表にまとめると、次のようになります。

Workflow Graph Swarm
経路を決めるのは 開発者(コードで固定) 開発者(ノード+エッジで定義) エージェント自身(自律的にハンドオフ)
実行の性質 決定的・逐次 決定的(依存のないノードは並列) 創発的・自律的
ループ なし あり(条件付きエッジで可能) あり
SDK での提供のされ方 設計パターン(別途 workflow ツールあり) 組み込みオーケストレーター 組み込みオーケストレーター
実装の入口 素の Agent をコードで連結 GraphBuilder Swarm

この「経路を誰が決めるか」という軸を頭に入れたうえで、次の章から実際に 3 つのパターンを 1 つずつ試していきます。


共通の題材とモデル

3 つのパターンは、それぞれ得意なことも書き方も違います。ただ、いきなり別々の題材で説明してしまうと「何がどう違うのか」が見えにくくなってしまいます。

そこで今回は、3 つとも同じ題材を実装して比べる ことにしました。題材はシンプルに、あるトピックについて次の 3 ステップで処理するものです。

  1. 調査(researcher) … トピックの重要な事実を挙げる
  2. 分析(analyst) … 調査結果から示唆を導く
  3. まとめ(writer) … 内容を短くまとめる

今回のトピックには、 「観葉植物を室内に置くこと」 を使います。この「調査 → 分析 → まとめ」という同じ流れを、Workflow / Graph / Swarm の 3 通りで書いてみることで、「同じ仕事でも、経路の決め方がこんなに違う」 という部分に注目できるようにしています。

使用するモデル

使用するモデルは、すべて Amazon Nova Lite 1.0 v1us.amazon.nova-lite-v1:0)にしました。トレーニングで使うハンズオン環境での実行を考慮した選定ですが、他のモデルでも動作するので、必要に応じて変更してください。

3 つのサンプルとも、次のように共通の BedrockModel を定義して使い回しています。

from strands import Agent
from strands.models.bedrock import BedrockModel

# 共通で使う Amazon Nova Lite モデル
model = BedrockModel(
    model_id="us.amazon.nova-lite-v1:0",
    region_name="us-west-2",
    temperature=0.3,
)

エージェントは、この model を渡しつつ、system_prompt で役割だけを変えて作成します。例えば調査担当(researcher)は次のようなイメージです。

researcher = Agent(
    model=model,
    system_prompt="あなたは調査担当です。トピックの重要な事実を箇条書きで3つ挙げてください。",
)

なお、今回のサンプルコードは以下の GitHub リポジトリにまとめています。記事中ではポイントとなる部分だけを抜粋して紹介するので、全体のコードはこちらを参照してください。

StrandsAgentsBasic/multiagent at main · tetsuo-nobe/StrandsAgentsBasic · GitHub

それでは、次から実際に 3 つのパターンを 1 つずつ試していきます。


パターン 1:Workflow

最初は、一番シンプルな Workflow です。

Workflow は、開発者がコードで実行順序を固定する パターンです。前の章で触れたとおり、これは SDK の専用オーケストレーターではなく、素の Agent をコードで順番に呼び出していく「設計パターン」になります。「1 番目のエージェントを呼んで、その結果を 2 番目に渡して、さらにその結果を 3 番目に渡す」——それをそのまま Python のコードとして書くだけです。

コード

まず、役割の違う 3 つのエージェントを用意します。それぞれ system_prompt で役割を変えているだけで、モデルは共通です。ここでは、後で結果だけをまとめて表示したいので callback_handler=None を指定し、途中のストリーム出力を抑制しています。

researcher = Agent(
    model=model,
    system_prompt="あなたは調査担当です。トピックの重要な事実を箇条書きで3つ挙げてください。",
    callback_handler=None,
)
analyst = Agent(
    model=model,
    system_prompt="あなたは分析担当です。与えられた調査結果から、最も重要な示唆を1つ導いてください。",
    callback_handler=None,
)
writer = Agent(
    model=model,
    system_prompt="あなたは執筆担当です。与えられた分析を3行以内の日本語でまとめてください。",
    callback_handler=None,
)

そして、実行の順序は次のように コードで固定 します。ここがこのパターンの肝です。あるエージェントの出力を、次のエージェントの入力として 自分で手渡し している点に注目してください。

def run_workflow(topic: str) -> str:
    # ステップ1: 調査
    research = researcher(f"次のトピックを調査してください: {topic}")

    # ステップ2: 分析(ステップ1の出力を入力として渡す)
    analysis = analyst(f"次の調査結果を分析してください:\n{research}")

    # ステップ3: まとめ(ステップ2の出力を入力として渡す)
    summary = writer(f"次の分析をまとめてください:\n{analysis}")

    return str(summary)

run_workflow("観葉植物を室内に置くこと")

見てのとおり、「次にどのエージェントを呼ぶか」は完全にコードで決まっています。LLM が経路を判断する余地はなく、分岐もループもありません。だからこそ、毎回まったく同じ順序で実行される(決定的) という安心感があります。

実行結果

実際に実行すると、researcher → analyst → writer の順に処理が進み、各ステップの出力が得られます。

--- ステップ1: 調査結果 ---
観葉植物を室内に置くことに関する重要な事実を以下に挙げます。

1.  **ストレス軽減と心理的利点**:
(以下略)

--- ステップ2: 分析結果 ---
調査結果から最も重要な示唆を1つ導くならば、**「観葉植物は心理的健康と室内の空気浄化の両面で重要な役割を果たす」**ということです。
(以下略)

--- ステップ3: 最終まとめ ---
観葉植物は心理的健康と室内の空気浄化の向上に役立つことが示唆されました。空気浄化とストレス軽減が相乗効果を生み、生活の質を高めます。観葉植物は単なる装飾ではなく、健康と快適さを総合的に向上させる手段です。

Workflow のポイント

Workflow は、とにかく コードを読めば挙動がそのままわかる のが良いところだと思います。処理の順序が決まっている定型作業を、複数のエージェントで分担させたいときには、これが一番シンプルで確実です。

一方で、「調査は複数の観点で並列にやりたい」「状況によって次の担当を変えたい」といった要求が出てくると、手続きコードだけでは少しずつ複雑になっていきます。そこで登場するのが、次の Graph です。


パターン 2:Graph

次は Graph です。

Graph は、開発者がノードとエッジで経路を定義する パターンです。エージェントを「ノード」として登録し、その間の依存関係を「エッジ」でつなぎます。Workflow との大きな違いは 2 つあります。

  • 出力の受け渡しを自分で書かなくてよい。エッジに沿って、あるノードの出力が次のノードの入力へ自動的に伝わります。
  • 依存関係のないノードは並列で実行される

この「並列実行」を体感するために、ここでは調査を 利点担当(positive)課題担当(negative) の 2 つに分け、両方が終わってから まとめ担当(writer) が合流する形にしてみます。図にすると次のようなイメージです。

positive ─┐
          ├─▶ writer
negative ─┘

コード

グラフの組み立ては GraphBuilder で行います。ノードを登録し、エッジで依存関係を宣言するだけです。

from strands.multiagent import GraphBuilder

builder = GraphBuilder()
builder.add_node(positive, "positive")
builder.add_node(negative, "negative")
builder.add_node(writer, "writer")

# positive と negative は依存がないため並列実行される。
# 両者が完了してから writer が実行される。
builder.add_edge("positive", "writer")
builder.add_edge("negative", "writer")

graph = builder.build()

result = graph("観葉植物を室内に置くこと")

ポイントは、positivenegative のどちらにもエッジが向いていない(=依存がない)ため、この 2 つは並列で実行される点です。そして両方に対して writer へのエッジが張られているので、2 つの調査が揃ってから writer が動きます。Workflow のときのように「researcher の結果を analyst に手で渡す」といったコードは、どこにも書いていないことに注目してください。

実行結果

実行後、result.execution_order で実行順序を確認できます。

--- 実行順序 ---
['positive', 'negative', 'writer']

--- 最終まとめ(writer ノードの出力)---
観葉植物を室内に置くことは、空気の浄化や心理的利点がある一方、光や湿度の管理が課題となる。適切な環境を提供することが植物の健康に重要である。

positivenegative(並列)→ writer(合流)という、宣言したグラフどおりの順序になっています。最終的なまとめは result.results["writer"].result から取り出せます。

Graph のポイント

Graph は、処理の流れを「構造」として宣言できる のが魅力だと思います。依存のない処理は自動で並列化されますし、条件付きのエッジを使えば分岐やループも表現できます。「業務プロセスのように、経路がある程度決まっているが並列や分岐も入る」というケースに向いていると感じました。

ただし、Workflow も Graph も 経路を決めるのは開発者 です。「経路そのものをエージェントに任せたい」という場合は、最後の Swarm が候補になります。


パターン 3:Swarm

最後は Swarm です。

Swarm は、これまでの 2 つと決定的に違います。Workflow も Graph も経路を決めるのは開発者でしたが、Swarm では 経路をエージェント自身が決めます。開発者がやることは、専門性の違うエージェントを「集まり(プール)」として渡すだけ。あとは各エージェントが「この先は自分より適任がいる」と判断すると、handoff_to_agent というツールで次の担当に制御を渡していきます(ハンドオフ)。

コード

エージェントには description を付けておきます。これは、他のエージェントが「誰にハンドオフすべきか」を判断するための手がかりになります。

researcher = Agent(
    name="researcher",
    model=model,
    description="トピックの事実や情報を調査する担当",
    system_prompt=(
        "あなたは調査担当です。トピックの重要な事実を簡潔に挙げてください。"
        "調査が済んだら analyst にハンドオフしてください。"
    ),
    callback_handler=None,
)
# analyst / writer も同様に description と system_prompt を設定

そして Swarm 本体は、エージェントのリストを渡すだけ です。Graph のようなエッジも、Workflow のような呼び出し順のコードも書きません。

from strands.multiagent import Swarm

swarm = Swarm(
    [researcher, analyst, writer],
    entry_point=researcher,  # 最初に受け取るエージェント(省略時は先頭)
    max_handoffs=10,
    max_iterations=10,
)

result = swarm("観葉植物を室内に置くこと")

entry_point で最初の担当だけは指定していますが、そこから先に誰へ渡すかはエージェントが自律的に判断 します。順序を保証するコードはどこにもありません。

実行結果

誰がどの順で担当したかは、result.node_history で確認できます。

--- ハンドオフの履歴(誰がどの順で担当したか)---
['researcher', 'analyst', 'writer']

--- 最終まとめ(writer の出力)---
<thinking>これまでの調査結果と分析を基に、観葉植物を室内に置くことに関する示唆を文章にまとめる必要がある。他エージェントへのハンドオフは不要。</thinking>
観葉植物を室内に置くことは、室内空気の質を改善し、ストレスを軽減する可能性がありますが、適切な管理が必要です。

このケースでは researcher → analyst → writer ときれいに流れましたが、これは開発者が固定した結果ではなく、エージェントたちが判断した結果 である点が Workflow・Graph との根本的な違いです。

Swarm のポイント

Swarm は、経路をあらかじめ決められない、あるいは決めたくないタスク に向いていると感じました。探索やブレインストーミング、複数の専門家の視点を持ち寄って結論を出すような場面では、この「自律的にハンドオフする」性質が活きてきます。

一方で、経路がエージェント任せになる分、挙動は毎回同じとは限りません。実際、今回のように小さめのモデル(Amazon Nova Lite)を使うと、担当が行ったり来たりして node_historyresearcher → analyst → writer → analyst → writer のように揺れることもありました。「毎回きっちり同じ順序で流したい」のであれば、経路を固定できる Graph の方が適しています。この揺らぎ自体が、Swarm の「創発的(emergent)」という性質を体感できる部分でもあります。


3 パターンの比較と使い分け

ここまで 3 つのパターンを実際に動かしてきました。改めて、違いを表で整理しておきます。

Workflow Graph Swarm
経路を決めるのは 開発者(コードで固定) 開発者(ノード+エッジで定義) エージェント自身(自律的にハンドオフ)
実行の性質 決定的・逐次 決定的(依存のないノードは並列) 創発的・自律的
ループ なし あり(条件付きエッジで可能) あり
SDK での提供のされ方 設計パターン(別途 workflow ツールあり) 組み込みオーケストレーター 組み込みオーケストレーター
実装の入口 素の Agent をコードで連結 GraphBuilder Swarm

こうして並べてみると、やはり 一番の判断軸は「実行の経路を誰が決めるか」 だと感じます。ここを起点に考えると、使い分けはシンプルに整理できます。

  • 決まった順序どおりに、シンプルに処理したいWorkflow 処理の流れが固定で、素直にコードで書けるなら、これが一番読みやすく確実です。
  • 経路は決まっているが、並列や分岐・ループも入れたいGraph 業務プロセスのように「流れはあるが、途中で並列化や条件分岐が必要」というケースに向いています。
  • 経路を事前に決められない/決めたくないSwarm 探索やブレインストーミング、複数の専門家の視点を持ち寄って結論を出すような、経路が読めないタスクに向いています。

言い換えると、「決定的にしたいか、それとも創発的(自律的)にしたいか」 が選択の大きな分かれ目になります。Workflow と Graph は開発者が経路をコントロールする決定的なアプローチ、Swarm はエージェントに任せる創発的なアプローチ、というわけですね。

なお、今回はどれも「調査 → 分析 → まとめ」という同じ題材で試しましたが、実際のアプリケーションでは、この 3 つを組み合わせて使うこともできます。例えば Graph のノードの 1 つとして Swarm を配置する、といった入れ子構成も可能です。まずはそれぞれの特性を押さえたうえで、解きたい問題に合わせて選んでいくのがよいと思います。


注意点

実際に試してみて気づいた点や、事前に知っておくとよい点をいくつかまとめておきます。

Swarm は経路が毎回同じとは限らない

Swarm は経路をエージェント自身が決めるため、同じ入力でも実行のたびに担当の順序が変わることがあります。特に今回のように小さめのモデル(Amazon Nova Lite)を使うと、担当が行ったり来たりして node_history が長くなることもありました。

「毎回きっちり同じ順序で流したい」という要件があるなら、無理に Swarm を使わず、経路を固定できる Graph(や Workflow)を選ぶ方が確実です。なお Swarm には、こうした無限ループやピンポン状態を防ぐための安全装置として、max_handoffs(ハンドオフの上限)や max_iterations(総反復回数の上限)といったパラメータが用意されています。タスクの複雑さに応じて調整しておくとよいでしょう。

実行結果はそのまま print すると冗長になる

Graph や Swarm の実行結果オブジェクトを print(result) でそのまま出力すると、各エージェントのメトリクスやトークン使用量などの内部情報まで一気に表示され、かなり読みにくくなります。

最終的な出力だけを見たい場合は、次のように必要な部分だけを取り出すのがおすすめです。

# 最後に担当した writer ノードの出力テキストだけを取り出す
print(result.results["writer"].result)

あわせて、各エージェントに callback_handler=None を指定しておくと、途中のストリーム出力(<thinking>...</thinking> やツール呼び出しの経過)が抑制され、結果だけをすっきり確認できます。

Workflow は「オーケストレーター」ではない

これは冒頭でも触れましたが、あらためて注意点として挙げておきます。Graph・Swarm は SDK 組み込みのオーケストレーターですが、Workflow は SDK の専用機能ではなく、コードでエージェントを連結する設計パターンです。

そのため「Workflow クラスをインポートする」といった使い方はしません。ただし、タスクの依存解決や並列実行を自動化したい場合は、strands-agents-toolsstrands_tools)パッケージの workflow ツールを利用するという選択肢もあります。

モデルやリージョンは環境に合わせて変更する

今回のサンプルはモデルに us.amazon.nova-lite-v1:0、リージョンに us-west-2 を指定しています。実行する環境によっては、モデルの有効化(Amazon Bedrock のモデルアクセス設定)やリージョンの変更が必要になります。手元の環境に合わせて BedrockModel の設定を調整してください。


最後に

今回は、Strands Agents SDK のマルチエージェントの 3 パターン、Workflow / Graph / Swarm を、同じ「調査 → 分析 → まとめ」という題材で実装して比べてみました。

最初は「どれも複数エージェントを動かすもの」で似たようなものだと思っていたのですが、実際に手を動かしてみると、一番の違いは「実行の経路を誰が決めるか」 にある、というのがはっきり実感できました。

  • Workflow … 開発者がコードで順序を固定する(設計パターン)
  • Graph … 開発者がノードとエッジで経路を定義する(並列や分岐も表現できる)
  • Swarm … エージェント自身が自律的に経路を決める(創発的)

そして、Graph・Swarm は SDK 組み込みのオーケストレーターである一方、Workflow はコードで組む設計パターンである、という立ち位置の違いも整理できました。

パターン選びで迷ったときは、「経路を決定的にしたいか、それとも創発的にしたいか」 をまず考えるとよいと思います。決まった流れを確実に回したいなら Workflow や Graph、経路が読めない探索的なタスクならば Swarm、という具合ですね。

今回はそれぞれを単独で試しましたが、Graph のノードに Swarm を入れ子にするなど、組み合わせて使うこともできます。今後はもう少し実践的なテーマで、これらのパターンを組み合わせた構成にも挑戦してみたいと思います。

なお、今回使用したサンプルコードは以下の GitHub リポジトリにまとめています。よければ手元でも動かしてみてください。

StrandsAgentsBasic/multiagent at main · tetsuo-nobe/StrandsAgentsBasic · GitHub

AWS Lambda のテナント分離モードを試してみた

仕事上、AWS 環境のリソースをマルチテナントで管理する手法について調査する機会があったのですが、「そういえば AWS Lambda でテナント分離モードって機能があったな」と思い出し、実際に試してみることにしました。

この記事に記載している内容は、2026年4月に検証した結果に基づいています。

なお、AWS 環境における SaaS 環境の構築やマルチテナント管理については下記のドキュメントも参考になるので紹介しておきます。

docs.aws.amazon.com

docs.aws.amazon.com


目次


AWS Lambda のテナント分離モード

  • AWS Lambda のテナント分離モードは 2025年11月に導入された機能ですが、それ以前までは SaaS のような環境でテナント別に Lambda 関数の実行環境を分離することはできませんでした。
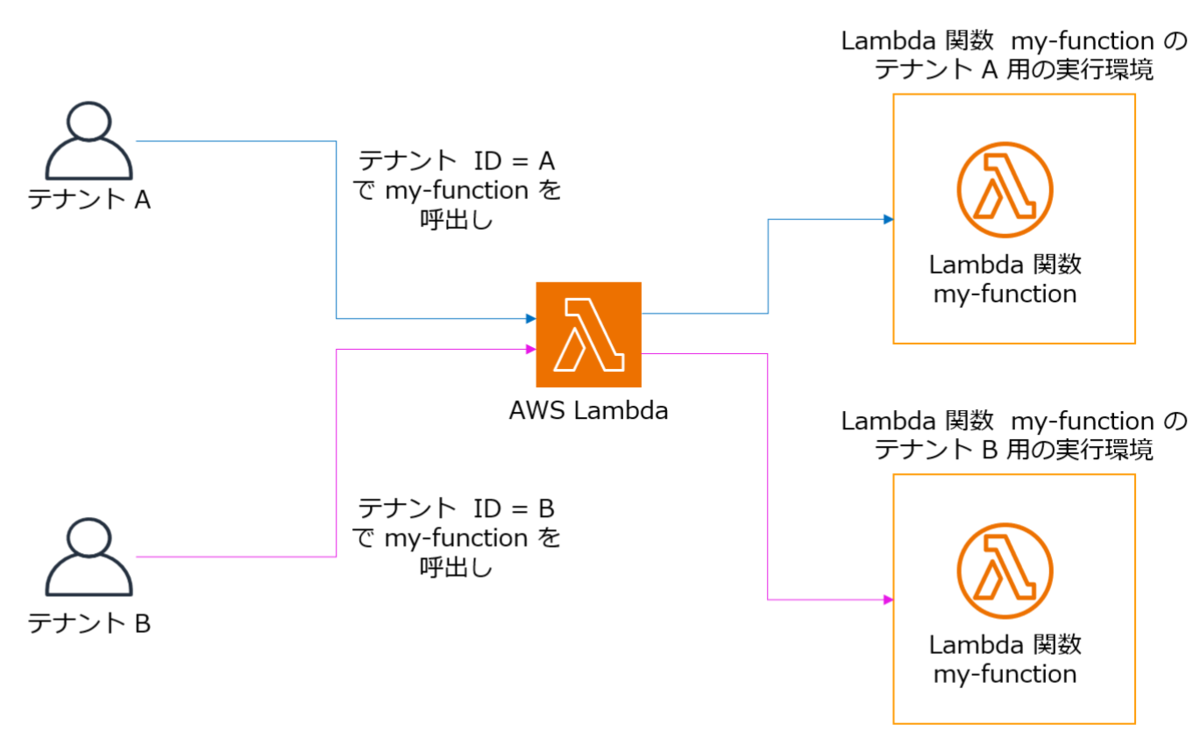
  • このテナント分離モードを指定することで、指定したテナントの ID 別に Lambda 関数の実行環境を分離することができます。
  • ただしこの機能にはいくつか注意点があるので、記事の後半で説明します。

  • AWS 公式のブログ記事でも、このテナント分離モードの紹介と簡単に試す手順が説明されています。

aws.amazon.com

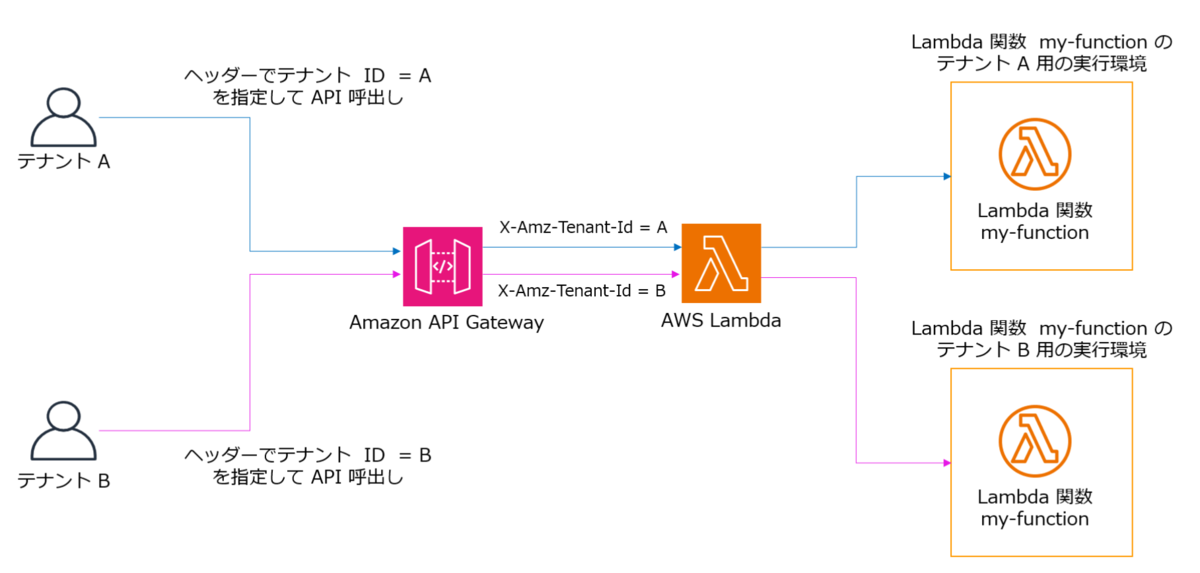
  • 上記のブログ記事の内容をベースに、今回は Amazon API Gateway の REST API を使用し、リクエストヘッダーにテナントの ID を指定して REST API 経由でテナント分離モードの Lambda 関数を呼び出してみたいと思います。


Lambda 関数のコード

  • 上記のブログ記事とほぼ全く同じです。テナント ID (tenant_id) は、Lambda 関数のハンドラーでコンテキストオブジェクトから取得します。
 """テナント分離モードが有効なLambda関数のハンドラー"""
    tenant_id = context.tenant_id
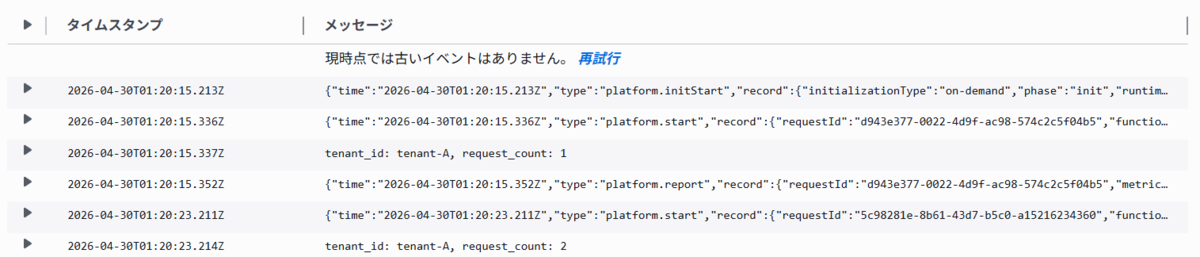
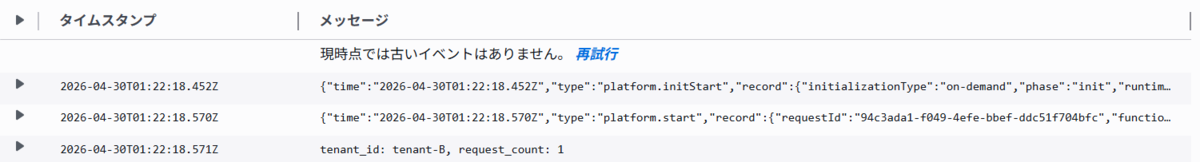
  • ただ、ログを出力するコード(下記)だけを追加しました。これにより、テナント毎に実行環境が異なるため、CloudWatch Logs のログループもテナント毎に異なることを確認したいと思います。
 # ログ
 print(f"tenant_id: {tenant_id}, request_count: {data['request_count']}")

AWS SAM テンプレート

  • 上記の Lambda 関数を Amazon API Gateway の REST API と統合してデプロイするための SAM テンプレートです。
  • リクエストのヘッダー x-tenand-id を X-Amz-Tenant-Id にマップして Lambda 関数を呼び出します。ここがポイントですね。

  • 下記はその部分の抜粋です。

  # POSTメソッド(x-tenant-id ヘッダーを X-Amz-Tenant-Id にマッピング)
  TenantApiMethod:
    Type: AWS::ApiGateway::Method
    Properties:
      RestApiId: !Ref TenantApi
      ResourceId: !Ref TenantApiResource
      HttpMethod: POST
      AuthorizationType: NONE
      RequestParameters:
        method.request.header.x-tenant-id: true
      Integration:
        Type: AWS_PROXY
        IntegrationHttpMethod: POST
        Uri: !Sub arn:aws:apigateway:${AWS::Region}:lambda:path/2015-03-31/functions/${TenantIsolatedFunction.Arn}/invocations
        RequestParameters:
          integration.request.header.X-Amz-Tenant-Id: method.request.header.x-tenant-id

実行確認

  • AWS SAM でデプロイが完了したら、curl コマンドで呼び出します。
  • まず テナント ID に tenant-A を指定して実行します。
curl -X POST https://abcdef1234.execute-api.ap-northeast-1.amazonaws.com/prod/process \
  -H "Content-Type: application/json" \
  -H "x-tenant-id: tenant-A" \
  -d '{"action": "process"}'
  • 結果
{
    "message": "File contents for tenant-A (isolated per tenant)",
    "file_data": {
        "tenant_id": "tenant-A",
        "request_count": 1,
        "first_request": "2026-04-30T01:58:01.534762",
        "requests": [
            {
                "request_number": 1,
                "timestamp": "2026-04-30T01:58:01.534787"
            }
        ]
    }
}
  • 続けて、再びテナント ID に tenant-A を指定して実行します。結果は下記のようになり、同一の実行環境が使用されるので、同じ /tmp/tenant_data.json ファイルにアクセスして、前回の結果を読み込めていることがわかります。
{
    "message": "File contents for tenant-A (isolated per tenant)",
    "file_data": {
        "tenant_id": "tenant-A",
        "request_count": 2,
        "first_request": "2026-04-30T01:58:01.534762",
        "requests": [
            {
                "request_number": 1,
                "timestamp": "2026-04-30T01:58:01.534787"
            },
            {
                "request_number": 2,
                "timestamp": "2026-04-30T01:58:07.027854"
            }
        ]
    }
}
  • CloudWatch Logs で Lambda 関数の実行ログをみても、同一のロググループでログイベントが出力されていることがわかります。

  • 次にテナント ID に tenant-B を指定して実行します。テナント ID が異なるため、異なる実行環境が使用され、/tmp/tenant_data.json ファイルも異なり、テナント A で実行された結果が読み込まれていないことがわかります。
{
    "message": "File contents for tenant-B (isolated per tenant)",
    "file_data": {
        "tenant_id": "tenant-B",
        "request_count": 1,
        "first_request": "2026-04-30T01:58:29.779452",
        "requests": [
            {
                "request_number": 1,
                "timestamp": "2026-04-30T01:58:29.779484"
            }
        ]
    }
}
  • CloudWatch Logs で Lambda 関数の実行ログをみても、tenant_id に A を指定した場合と異なるロググループでログイベントが出力されていることがわかります。

  • 単一の Lamda 関数でもテナント ID 別に実行環境が分離されていることを確認できました。

  • ちなみに、テナント ID を指定せずに実行すると、次のようなエラーになります。

{
    "message": "The invoked function is enabled with tenancy configuration. Add a valid tenant ID in your request and try again."
}

注意点

テナント分離モードを使うこと自体は難しくありませんが、以下のような 注意点 があるので意識しておきましょう。

  • テナント分離モードは関数作成時にのみ設定可能です。既存の関数に対して後から有効化することはできません。
  • テナント分離モード使用時は、コンソールや AWS CLI 、 AWS SDK のコードから テナント ID を指定して呼び出す必要があります。
  • イベントソースとして他の AWS サービスと連携する場合は、Amazon API Gateway の REST API のみ使用できます。
  • テナントごとに新しい実行環境が作成されるため、コールドスタートが増加する可能性があります。
  • Amazon API Gateway と統合する場合は、REST API を使用しています。
    • HTTP API ではヘッダーオーバーライドができないため、使用できません。
  • テナント分離実行環境の作成時に追加料金が発生します。

参考リンク


チャットのストリーム表示における Amazon API Gateway の WebSocket API の活用

本記事は「Serverless Advent Calendar 2025」7 日目の記事です。


チャットアプリケーションのストリーミング表示の方法について

基盤モデルを使って Web ベースのチャットアプリケーションを作成するケースはよく見受けられますよね。 私も基盤モデルを使用するアプリケーションのデモやサンプルとして、よく作ります。

その際、「レスポンスのメッセージのストリーミングで表示したい」 というニーズも多いと思います。

世の中には色々な SDK がありますが、基盤モデルを直接呼び出す API でも、AI エージェントをコントロールする API でも、ストリーミングでレスポンスを得る API は、だいたい用意されています。

なので、それらを使えばいい、ということになるのですが、チャットアプリケーションの構造によって適用できる技術やフレームワーク、ランタイムが変わってきます。

例えば、Streamlit を使用し、そのコードの中でストリーミングのレスポンスを得る API を使用して実装し、コンテナにしてサーバーサイドで動作させるだけなら、至極シンプルで、何の問題もありません。

では、サーバーレスのコンピューティング環境として AWS Lambda を使いたい場合はどうでしょうか?

AWS Lambda を単体で使うなら、関数 URL を活用することもできます。

docs.aws.amazon.com

ただ、Amazon API Gateway と AWS Lambda を組み合わせた構成の場合はどうでしょうか?

そういった場合に役立つ Amazon API Gateway の Update が 2025年11月 に発表されました。

「Amazon API Gateway の REST API で AWS Lambda 関数と統合した場合のレスポンスストリームをサポート」

aws.amazon.com

これは とてもよい Update だと思いますし、すでに多くの人に試され、その感触などが様々なブログ記事で公開されています。

ただ、AWS Lambda 関数と組み合わせる場合は、AWS Lambda の InvokeWithResponseStream API を使うことになり、ランタイムは Node.js が前提です。

docs.aws.amazon.com

docs.aws.amazon.com

もし、Node.js 以外のランタイムを使いたい場合は、Web Adapter の使用などを検討することになります。

では、AWS Lambda の関数 ランタイムとして Node.js 以外を使いたい、 Web Adapter を使いたくない、という場合はどうでしょうか?

その場合は、Amazon API Gateway の WebSocket API と AWS Lambda 関数を組み合わせる という方法もあります。

今回は、この方法を試してみたいと思います。


今回作成するアプリケーションの構成

  • Amazon API Gateway で sendtext というハンドラを用意して、AWS Lambda 関数と統合します。
  • AWS Lambda 関数は、受け取ったメッセージを Amazon Bedrock に対して converse_stream という API で送信します。
    • この AWS Lambda 関数は関数 URL や WebAdapter を使う必要はなく、ランタイムは Python 3.13 を使用しています。
  • そのレスポンスをストリームで受け取り、Amazon API Gateway へ返信します。
  • フロントエンドでは、Amazon API Gateway の WebSocket API のエンドポイントの URL に対して WebSocket の接続を維持して、sendtext のハンドラが実行されるようにメッセージを送信し、レスポンスを受信します。

フロントエンドに Streamlit を使うことも検討したのですが、WebSocket の接続を維持するためのコードが複雑になったので、Next.js での実装に切り替えました。


AWS Lambda 関数

  • sendtxt ハンドラとなる AWS Lambda 関数では、Amazon Bedrock の基盤モデルに対して converse_stream API でメッセージを送信します。
  • 基盤モデルからのストリームレスポンスは、Amazon API Gateway に対して post_to_connection API でメッセージを返信します。
import boto3
import json
import os

API_ENDPOINT = os.environ["API_ENDPOINT"]
STAGE = os.environ["STAGE"]
MODEL_ID = os.environ["MODEL_ID"]

# 推論パラメータの値
temperature = 0.5

# 推論パラメータの値の設定
inference_config = {"temperature": temperature}


# システムプロンプト
system_prompts = [{"text": "あなたは優秀なアシスタントです。問い合わせ内容に丁寧に応答して下さい。"}]

def lambda_handler(event,context):
    # AWS SDK のクライアントオブジェクトの作成
    brt = boto3.client(service_name='bedrock-runtime')
    apigw_management = boto3.client('apigatewaymanagementapi', endpoint_url=f"{API_ENDPOINT}/{STAGE}")

    # 接続 ID の取得
    connectionId = event.get('requestContext', {}).get('connectionId')

    # メッセージの取得
    body_content = json.loads(event.get('body', {}))

    # 基盤モデルへのリクエストメッセージの構成
    text = body_content.get('text')
    message_1 = {
      "role": "user",
      "content": [{"text": f"{text}"}]
    }
    messages = []

    messages.append(message_1)
    
    # Bedrock の基盤モデルの ID を指定
    modelId = MODEL_ID

    # Bedrock の基盤モデルへリクエストを送信
    try:
        response = brt.converse_stream(modelId=modelId,messages=messages,system=system_prompts,inferenceConfig=inference_config)
    except Exception as e:
        return {
            "statusCode": 500,
            "body": f"{e}"
        }
    # レスポンスを取得し、Amazon API Gateway へ返信
    for event in response.get('stream'):
         if 'contentBlockDelta' in event:
            chunk = event['contentBlockDelta']['delta']['text']
            try:
                apigw_management.post_to_connection(ConnectionId=connectionId, Data=json.dumps(chunk))
            except Exception as e:
                return {
                    "statusCode": 500,
                    "body": f"{e}"
                }

    return {
        "statusCode": 200
    }

この AWS Lambda 関数と Amazon API Gateway の WebSocket API と、その統合を作成する AWS SAM テンプレートはこちらの GitHub リポジトリ から参照できです。


フロントエンド

ストリーム表示に関わる部分だけフォーカスして説明します。

下記では、useEffect で WebSocket の接続を作成・維持を行っています。また、ws.onmessage でメッセージを細切れに受け取り、useState で管理している messages へ格納しています。

export default function Chat() {
  const [messages, setMessages] = useState<Message[]>([]);
  const [input, setInput] = useState("");
  const [isConnected, setIsConnected] = useState(false);
  const wsRef = useRef<WebSocket | null>(null);
  const currentResponseRef = useRef<string>("");
  const currentMessageIdRef = useRef<number | null>(null);

  useEffect(() => {
    const ws = new WebSocket(process.env.NEXT_PUBLIC_WebSocket_URL!);
    wsRef.current = ws;

    ws.onopen = () => setIsConnected(true);
    ws.onclose = () => setIsConnected(false);
    ws.onerror = () => setIsConnected(false);
    
    ws.onmessage = (event) => {
      const data = JSON.parse(event.data);
      const messageText = String(data);
      
      currentResponseRef.current += messageText;
      
      if (currentMessageIdRef.current) {
        setMessages(prev => 
          prev.map(msg => 
            msg.id === currentMessageIdRef.current 
              ? { ...msg, text: currentResponseRef.current }
              : msg
          )
        );
      }
    };

    return () => ws.close();
  }, []);

下記は WebSocket でユーザーのメッセージを送信しています。

 wsRef.current.send(JSON.stringify({
      action: "sendtext",
      text: promptWithHistory
    }));

下記は useState で管理している messages を表示している部分です。

<div className="flex-1 overflow-y-auto p-4 space-y-4">
        {messages.map((message) => (
          <div
            key={message.id}
            className={`flex ${message.isUser ? "justify-start" : "justify-end"}`}
          >
            <div
              className={`max-w-md px-4 py-2 rounded-lg break-words ${
                message.isUser
                  ? "bg-yellow-200 text-black"
                  : "bg-green-200 text-black"
              }`}
            >
              {message.text}
            </div>
          </div>
        ))}
      </div>

上記以外のフロントエンドのプロジェクトのリソースは こちらのGitHub のリポジトリ にまとめています。 フロントエンドのコードは、Amazon Q Developer の力を借りて作成したので、1時間ほどで作成できました。

完成イメージ


注意点

Amazon API Gateway の WebSocket API は、リクエスト数だけでなく接続時間にも課金されます。 これは REST API とは異なりますので注意しましょう。

aws.amazon.com


最後に

基盤モデルを使ったチャットアプリケーションのようにレスポンスをストリーム表示するような場合で AWS のサーバーレスのサービスを使う場合は、いくつか方法はありますが、Amazon API Gateway の WebSocket API を活用することで、統合する AWS Lambda 関数のコードをシンプルにできるというメリットを感じました。

もちろん、2025年11月に Update された Amazon API Gateway の REST API のレスポンスストリーム対応も役立ちますが、WebSocket API の場合は、AWS Lambda 関数のランタイムを Node.js にする必要がなく、Web Adapter も不要であることはメリットといえると思います。
WebSocket API 料金は意識しておく必要はありますが、サーバーレスでの実装パターンの一つとして今後も活用していきたいと思います。


非ベンダー主催の生成 AI 認定 3冠 になったので振返ってみた

生成 AI の認定資格には色々ありますよね。

AWSGoogleMicrosoft などのベンダーが実施している試験もあります。

私も AWS の認定は取得しましたが、一方でベンダーが絡まず、純粋に基礎から体系的に生成 AI 関連のスキルを確認・測定できる認定試験にも強い関心をもっていました。

そこで、国内の下記の生成 AI に関する3つの認定を取得したので、その内容を振り返ってみたいと思います。

なお、このブログ記事の内容は 2025 年 6 月時点の情報に基づいています。 試験の情報は更新されることもありますので、ご注意ください。

上記 3つはいずれも生成 AI の初学者の方でもチャレンジできる認定試験ですので、興味があれば以下の記載を参考にしてください。


生成 AI パスポート

生成 AI パスポートは、一般社団法人生成AI活用普及協会 (GUGA) が実施している試験です。 問題形式は選択式で、自宅でオンラインで受験できます。 私は 2024 年 6 月に受験して合格しました。

問題形式 問題数 試験時間 合格基準
選択式 60 60分 開示していない

以下、生成 AI パスポートを受験した所感です。

  • 適度なシラバスの範囲

    • 生成 AI について基礎から体系的に学びその知識を試す、という私の目的を満たしてくれる試験の一つであったといえます。 シラバスの範囲としても、AI や 生成AIの基礎知識、現状の動向、実践的な活用方法、活用時の注意点など、基本的に理解しておきたいトピックを網羅できています。
    • 生成 AI を構築するための深層学習の手法やアルゴリズムの種類についても問われます。深いレベルでは問われないので恐れる必要はありませんが、初心者の方にはこの分野の聞きなれない言葉や用語の暗記に一苦労するかもしれません。
  • 試験の学習教材が豊富

    • 一般書籍として、試験の参考書、問題集が発刊されています。
    • 無料の生成 AI パスポート AIクイズアプリをスマホから利用できます。
    • 私はこれらの教材を2周ほど学習して試験に臨み、合格に役立ったと言えます。
  • 試験の実施期間に注意
    • 試験はいつでも受験できるわけではなく、実施期間は限られていますので注意しましょう。
    • 2025年の場合は、2月、6月、10月に実施されます。
    • 合否は、受験後しばらく経ってからの発表になります。私は 2024年に受験しましたが、一か月後にようやく合格していることを確認できました。

合否発表まで待っている期間はヤキモキしますが、3つの認定試験の中でシラバス範囲はバランスがよく、かつ教材も豊富で学習しやすいという印象を持ちました。


Prompt Engineering Professional - PEP

Prompt Engineering Professional - PEP は、一般社団法人日本プロンプトエンジニアリング協会が実施している試験です。 問題形式は選択式で、テストセンターでの受験となります。 私は 2025 年 5 月に受験して合格しました。

問題形式 問題数 試験時間 合格基準
選択式 100 60分 70%以上の正解

以下、Prompt Engineering Professional - PEP を受験した所感です。

  • 生成 AI の活用にフォーカスしている
    • 私は 生成 AI パスポートを合格した後にこの試験を受験したのですが、生成 AI パスポートとシラバス範囲が似ている部分もあるので、以前に学習した知識を活用できました。
    • 試験名に「Prompt Engineering」という言葉が含まれている通り、プロンプトエンジニアリングについても問われる問題が一定量出題されます。また ChatGPT など、一般的によく使用されている生成 AI のサービスの活用についても問われる問題も出題されるので、"生成 AI の実際の活用" にフォーカスしている印象を受けました。
  • 公式の学習資料が役立つ
    • この記事の執筆時点では試験の参考書や問題集は一般書籍として発刊されていませんが、シラバスに沿った学習資料が公式サイトから入手できます。
    • この学習資料が、試験に役立ちます。私もこれらの資料を2~3周ほど学習して試験に臨み合格できました。
  • 試験日時は選択可能だがテストセンターで受験
    • 試験はテストセンターまで赴く必要はありますが、私は AWS の認定試験で慣れているので特に苦になりませんでした。
    • 合否結果は、受験後にすぐに提示してくれるのも、個人的にありがたいです。

シラバスに沿った学習資料が公開されていることや、私は生成 AI パスポート合格後にこの試験を受けたことあり、この試験は個人的には難易度はあまり高くないと感じました。深層学習などの知識よりも、生成 AI を実際に活用する部分にフォーカスしている印象なので、「今、生成 AI をよく使っている」という方には取り組みやすい試験ではないかと感じました。


Gen AI Test

Gen AI Test は、一般社団法人日本ディープラーニング協会が実施している試験です。 問題形式は選択式 (19 問) と記述式(1 問)で、自宅でオンラインで受験できます。 私は 2025 年 6 月に受験して合格しました。

問題形式 問題数 試験時間 合格基準
選択式 19問と記述式 1問 20 20分 非公開

以下、Gen AI Test を受験した所感です。

  • シラバス範囲、問題量ともに多くない
    • Gen AI Test は問題数が 20 問で、シラバス範囲も他の2つの試験と比較し多くはありません。
    • そういう意味では、チャレンジのハードルが高くないともいえます。
  • 試験対策の教材は多くない
    • 例題・過去問の一部や試験に関して説明する動画や、参考資料は公開されており、それはそれで役に立ちますが他の2つの試験と比較して教材は多いとはいえません。
    • ただし試験を実施している日本ディープラーニング協会は、G 検定を実施している団体でもあり、生成 AI や深層学習に関連する用語の解説は G 検定向けの情報や教材をみることでカバーできます。
  • 試験の実施期間に注意
    • 試験はいつでも受験できるわけではなく、実施期間は限られていますので注意しましょう。
    • 2025 年の場合は、6 月に 1 回目が実施されました。2 回目についてはまだ情報が公開されていません。ただ、2024 年度の実績をみると 2 回実施されていますので今後の開催の情報を確認してみてください。

この試験は他の2つと比較し、問題数が少ないので「勉強したぞ!そして合格できたぞ!」という感覚を得られにくいかもしれません。ただ他の2つの試験と異なり、記述問題が出題されます。この記述問題は自分の実力を測るのには適していると感じています。選択式の問題と異なり、記述問題の場合は本当に問題の意味を理解していないと回答を記述することができません。記述問題の出題は 1 問だけではありますが、真の実力を測定するという意味では、良い経験ができたと感じています。


以上です。 今後、上記の認定取得に興味がある方は参考にしていただければ幸いです。

生成 AI は、昨今非常に注目されている分野ですので、今後また新しい認定試験が出るかもしれませんね。 その場合はまたチャレンジしようと思います!


Amazon Bedrock ナレッジベースの Web クローラーを触ってみた

本記事は「Amazon Bedrock Advent Calendar 2024」22 日目の記事です。

re:Invent 2024 での Update と関連のないトピックですみませんmm


Amazon Bedrock ナレッジベース のデータソースについて

Amazon Bedrock ナレッジベースは、検索拡張生成 (RAG) を使用した生成 AI アプリケーションを構築するのに役立ちます。

docs.aws.amazon.com

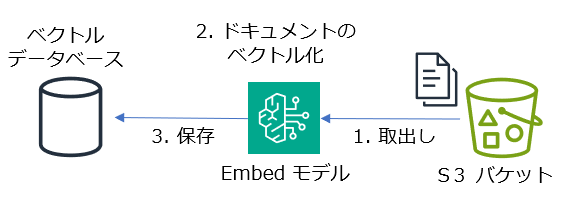
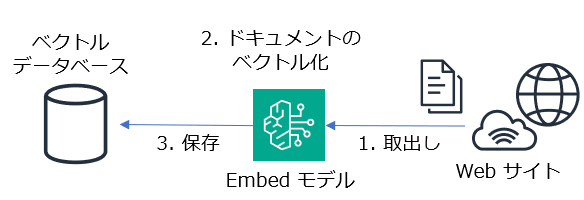
通常、ベクトルデータベースを使用した RAG の仕組みを構築する場合は、次のような処理を実装する必要があります。

事前処理

  1. データソースからドキュメントを取り出す
  2. 埋め込みモデルでドキュメント内のテキストのベクトル値を取得する
  3. ベクトル値をデータベース(ベクトルデータベース)に保存する

(下図は例です)

推論実行時の処理

  1. 埋め込みモデルでプロンプトのテキストのベクトル値を取得する
  2. ベクトルデータベースからプロンプトのベクトル値と類似するドキュメントを取得する
  3. 取得した類似ドキュメントをコンテキストとしてプロンプトに含め、テキスト生成モデルに推論を実行する

(下図は例です)

Amazon Bedrock ナレッジベースの場合は、AWS マネジメントコンソールを使用すれば上記の事前処理を設定作業だけで実現できます。 また推論実行時の処理もナレッジベースが提供する API を使用するだけで内部的に実行してくれるので、アプリケーション側で 上記の 1 から 3 の処理を実装する必要がありません。

下図は Amazon Bedrock ナレッジベースを使用した場合の処理の流れです。 流れが複雑にみえるかもしれませんが、ナレッジベースを作成しておけば、アプリケーションからはその API を呼び出すだけでよいという部分に着目して下さい。

(下図は データソースとして Amazon S3 バケットを使用している例です)

このナレッジベースでデータソースとして使用できるのは、この記事を執筆している 2024年12月時点では下記となります。

  • ベクトルストアを使用する場合のデータソース
  • Amazon Kendra を使用する場合のデータソース
  • 構造化データストアを使用する場合のデータソース

ただし、ベクトルストアを使用する場合のデータソースとしては、上記以外で、プレビュー として Web クローラーやConfluence、SalesforceSharepoint も試すことができます。

この記事では、このうち Web クローラーを試してみた結果を紹介したいと思います。

ただし、2024年12月現在 Web クローラーはプレビューリリースであり、今後変更される可能性があることはご注意下さい。


Web クローラーをデータソースに指定した場合のイメージ

Web クローラーをデータソースに指定するということは、推論実行時にコンテキストとして参照させたいドキュメントは、Web サイトに存在するという前提になります。

今回、Web クローラーを試すにあたって、デモ用の Web サイトを用意しました。これは、AnyCompany という架空の会社の最新情報を発しするニュースリリースサイトという想定です。(内容が プアなのはご容赦下さいw)  このサイトには、AnyCompany 社の決算説明資料として PDF ファイルもリンクされています。

AnyCompany (架空の会社)のニュースリリースサイト


AWS マネジメントコンソールでの設定の流れ

まず、Amazon Bedrock のコンソールの左側ナビゲーションメニューから [オーケストレーション] - [ナレッジベース] を選択します。右側に表示される [ナレッジベースの作成] を選択し、[Knowledge Base with vector store] を選択します。

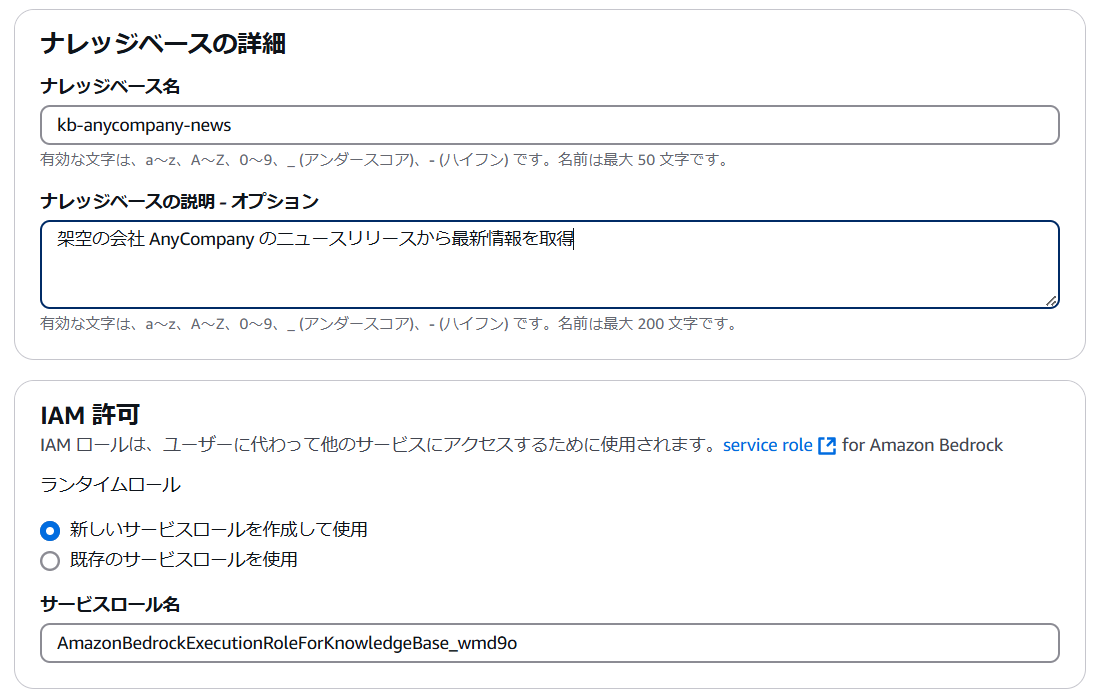
ナレッジベースの名前や説明を入力します。IAM ロールは今回は [新しいサービスロールを作成して使用] を選択しました。

次にデータソースとして [Web Crawler - Preview] を選択します。

それ以外は今回はデフォルトのまま、[次へ] を選択します。

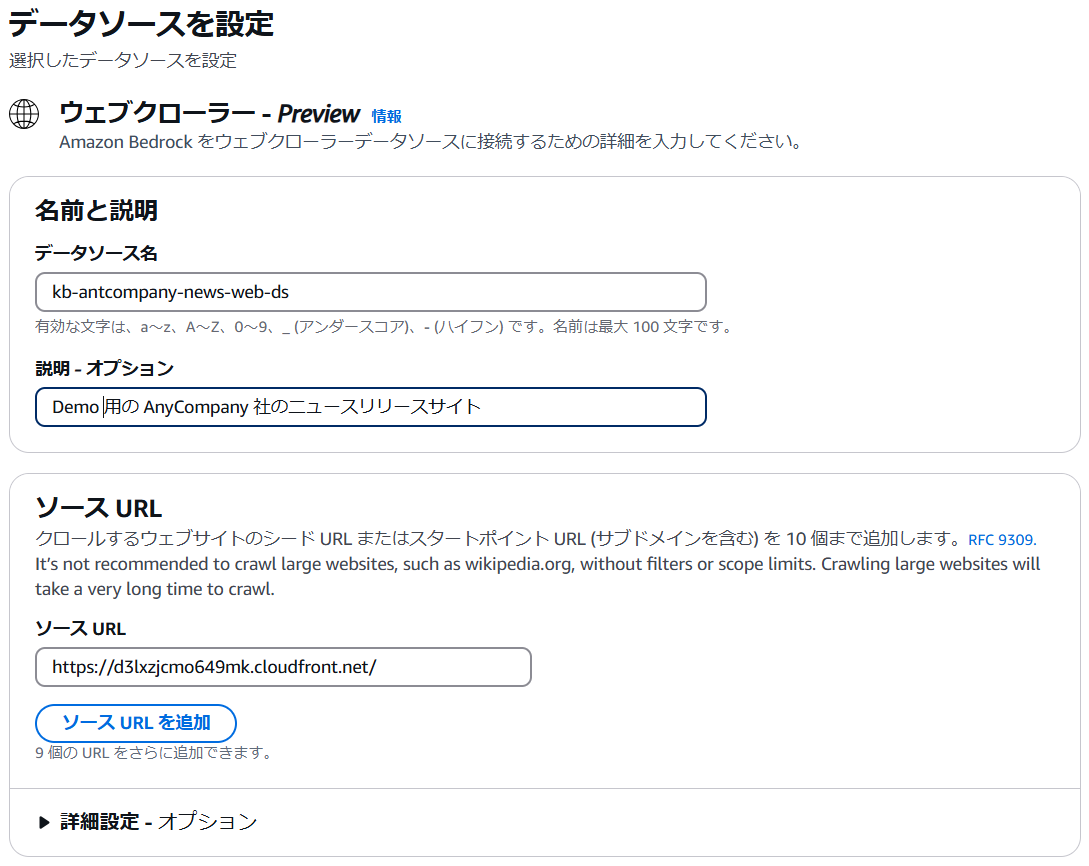
次にデータソース名や クロール対象となる URL を設定します。

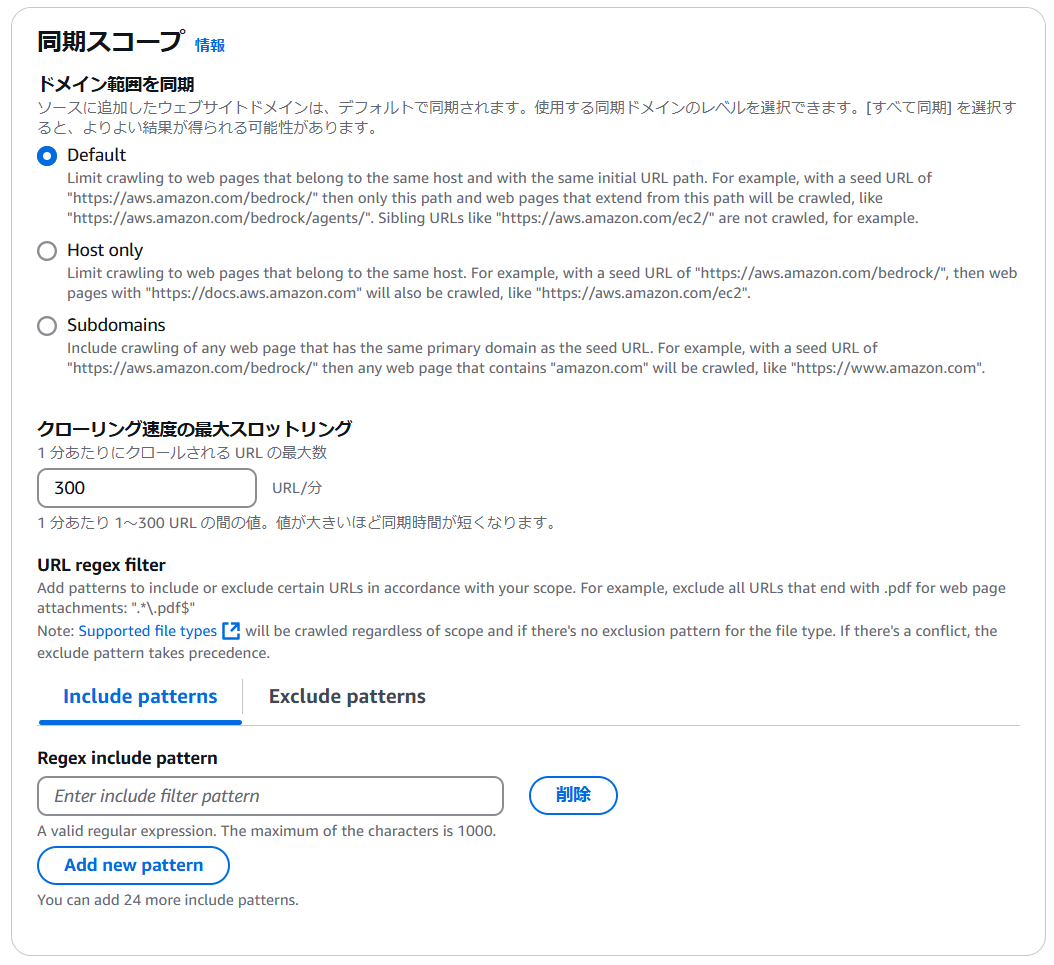
その下に [同期スコープ] というセクションがあり、クロール対象とするドメイン範囲や、対象ファイルの Regex パターンなどを設定できますが、今回はデフォルトのままとしました。

例えばドメイン範囲では、次のようなオプションを選択できます。

オプション 概要
Default 同じホストに属し、同じ初期 URL パスを持つ Web ページにクロールを制限します。たとえば、シード URL が「https://aws.amazon.com/bedrock/」の場合、このパスと、このパスから拡張された Web ページ (「https://aws.amazon.com/bedrock/agents/」など) のみがクロールされます。たとえば、「https://aws.amazon.com/ec2/」などの兄弟 URL はクロールされません。
Host only クロール対象を同じホストに属する Web ページに制限します。たとえば、シード URL が「https://aws.amazon.com/bedrock/」の場合、「https://docs.aws.amazon.com」を含む Web ページ (「https://aws.amazon.com/ec2」など) もクロールされます。
Subdomains シード URL と同じプライマリ ドメインを持つすべての Web ページのクロールを含めます。たとえば、シード URL が「https://aws.amazon.com/bedrock/」の場合、「https://www.amazon.com」のように「amazon.com」を含むすべての Web ページがクロールされます。

それ以外は今回はデフォルトのまま、[次へ] を選択します。

次に埋め込みモデルを選択します。今回は多言語に対応していることやコストなども考慮し、Amazon Titan Text Embeddings v2 を選択しました。

さらにベクトル値を格納するベクトルデータベースを選択します。

ここは注意が必要です。 Web クローラーをデータソースに選択した場合はベクトルデータベースとして Amazon OpenSearch Serverless を指定する必要があります。 当初、Amazon OpenSearch Serverless 以外をベクトルデータベースとして指定して作成しようとしたのですが、下記のエラーが表示されました。

データソース「kb-anycompany-news-web-ds」をナレッジベースに追加できませんでした。 WEB data source is currently only supported for knowledge bases created with an Amazon OpenSearch Serverless vector database.

そのため今回は、[新しいベクトルストアをクイック作成] を選択しました。ただし、Amazon OpenSearch Serverless を使用するコストには十分ご注意ください。 今回は、動作確認後にナレッジベースも Amazon OpenSearch Serverless も削除することにします。

それ以外は今回はデフォルトのまま、[次へ] を選択し、ナレッジベースを作成します。

作成が完了すると、次のようなメッセージが表示されます。

次に同期処理が必要になるので、[データソース] のセクションで作成したナレッジベースのチェックボックスをチェックして、[同期] を選択します。

同期の時間は対象データの量に依りますが、今回のクロール対象の Webサイトはさほどデータ量は多くないので数分待つと完了し、次のようなメッセージが表示されます。

これでナレッジベースが使えるようになりました。

では引き続きマネジメントコンソールを使用してテストしてみましょう。

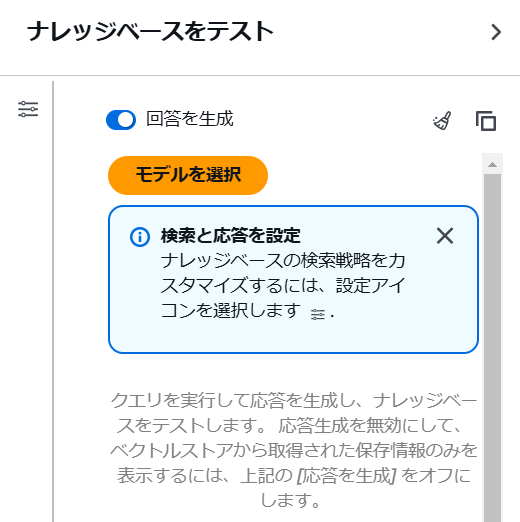
ページ右側にある [ナレッジベースをテスト] で 推論に使うテキスト生成モデルを選択します。

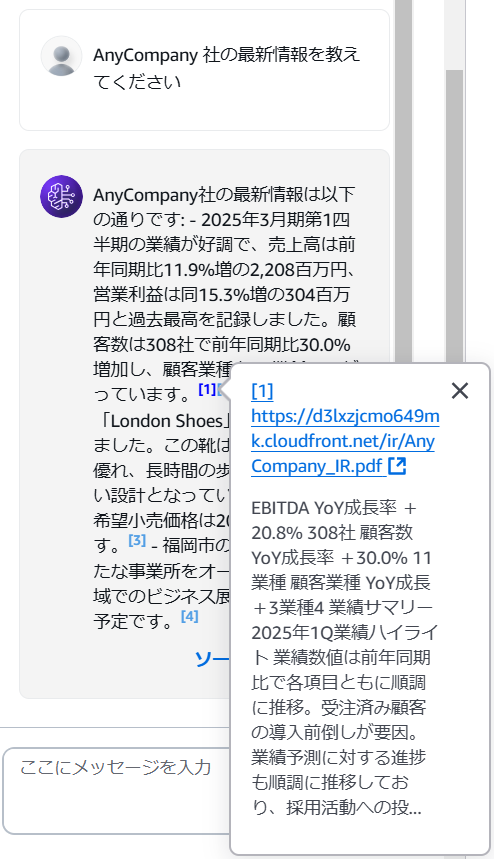
その後、「AnyCompany 社の最新情報を教えてください」と問い合わせてみます。

上図は例ですが、Web サイトの情報から回答を出せていることがわかりますね!

回答の中には、[1] や [2] など、参照先を示すリンクもありますが、それらをクリックしても指定した Web サイトや Web サイトにリンクされている PDF ファイルを参照していることがわかります。

これで、Web クローラーが正しく動作していることが確認できました!


最後に

RAG の仕組みを実装する上では、使用したいドキュメントや情報が Amazon S3 バケットではなく、Web サイトに存在している場合もありえます。 Amazon Bedrock のナレッジベースの Web クローラーを今回試してみて、そういったケースではシンプルに使用できて非常に有益であると実感できました。

今回は基本的な機能だけを試してみましたが、下記のドキュメントに詳細が記載されているので、詳細を知りたい方はご参照ください。

docs.aws.amazon.com

ただし、2024年12月時点では Web クローラーはプレビューであることは十分、ご留意ください。

また、不要であればナレッジベースとそのベクトルデータベースは削除しましょう。Amazon OpenSearch Serverless の場合、OpenSearch のコンソールからコレクションやセキュリティの各種ポリシーも削除しておきましょう。

ではみなさん、よいクリスマスを!


AWS Step Functions を使用したサーキットブレーカーパターンの実装について

本記事は「AWS LambdaとServerless Advent Calendar 2024」15 日目の記事です。

以前から下記のブログに関心があったので、実際に試してみたり、自分なりに改良を加えてみたのでそれを記事にします。

aws.amazon.com


目次


サーキットブレーカーとは

まず、サーキットブレーカーとは何かというところ確認しておきます。 アプリケーション開発の文脈でいうと、サーキットブレーカーとはサービス呼び出しが正常に行えない場合に、過剰にリクエストを送信しないための仕組みのことを指し、その仕組みの実装パターンを、サーキットブレーカーパターンと呼んでいます。

サーキットブレーカーパターンは、下記の AWS 規範ガイドにも説明がありますので目を通しておくと理解が深まります。

docs.aws.amazon.com

ちなみに「サーキットブレーカー」という言葉は、アプリケーション開発以外の場面でも使われます。 例えば、電流を制御する物理的な装置もサーキットブレーカーと呼ばれますし、株式の取引でも急激な株価の下降を止めるために取引を停止することをサーキットブレーカーと呼ぶこともあります。

サーキットブレーカーパターンの実装例

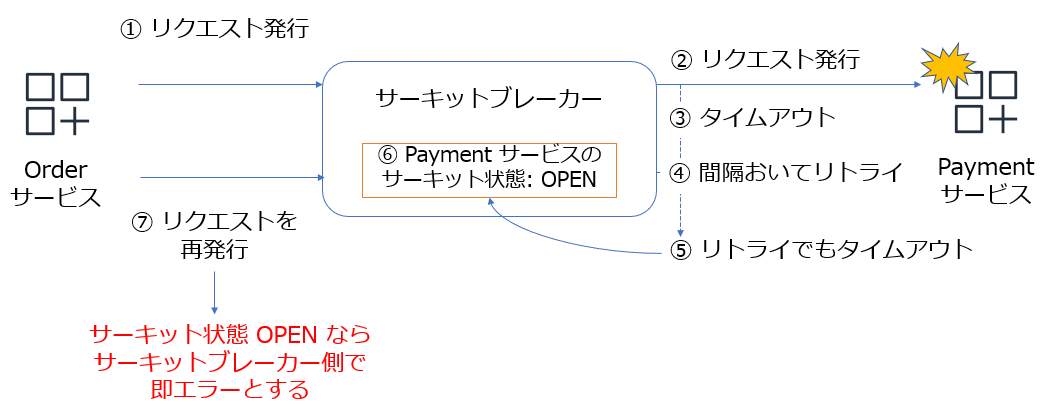
このサーキットブレーカーパターンの実装を紹介しているのが上で紹介した Using the circuit breaker pattern with AWS Step Functions and Amazon DynamoDB というブログ記事です。 そのブログ記事のサーキットブレーカーの動作を図にしてみました。

上の図では、サーキットブレーカーが Payment サービスが使用できない状態を「サーキット状態 = OPEN 」として保存しています。 サーキット状態が OPEN であれば、次のリクエストでは Payment サービスは呼び出さずエラーにしています。 ただし、Payment サービスが復旧することに備えて、この状態の保存には期限を設けることを前提としています。 これを実際に実装したイメージが下図になります。(ブログ記事からの抜粋した図です)

https://d2908q01vomqb2.cloudfront.net/1b6453892473a467d07372d45eb05abc2031647a/2022/01/30/Screen-Shot-2022-01-30-at-10.52.11-AM.png

サーキット状態の保存には Amazon DynamoDB テーブルを使用していますが、項目の有効期限 (Time To Live) を設定しておきます。 これにより、Payment サービスが復旧した場合に、サーキット状態=OPEN という項目が残り続けてリクエストを拒否する動作を避けることができます。

実際に試してみましたが、この実装には下記の利点があると感じました。

  • シンプルに実装できる
    • サービスを呼び出す側にサーキットブレーカーの実装を含めなくてよく、サーキットブレーカーを独立させて汎用的に使用できます。
  • サーキットブレーカーの動作や状態を可視化しやすい
    • AWS Step Functions のステートマシンで実装されているので、AWS マネジメントコンソールでその実行を可視化、トレースできますし、サーキット状態も DynamoDB のテーブルの内容をみることですぐに確認できます。

サーキットブレーカーパターンの実装例を自分なりに改良してみる

上記で紹介したサーキットブレーカーパターンの実装は、サンプルとしては十分ですが、実際に使うとなった場合は、下記のようにいくつか機能面で不足していることに気づきました。

  1. Order サービスが、Payment サービスに Payload を渡せる実装になっていない
  2. サーキット状態が OPEN のため呼び出しを行わない場合、Payload を退避させる実装になっていない

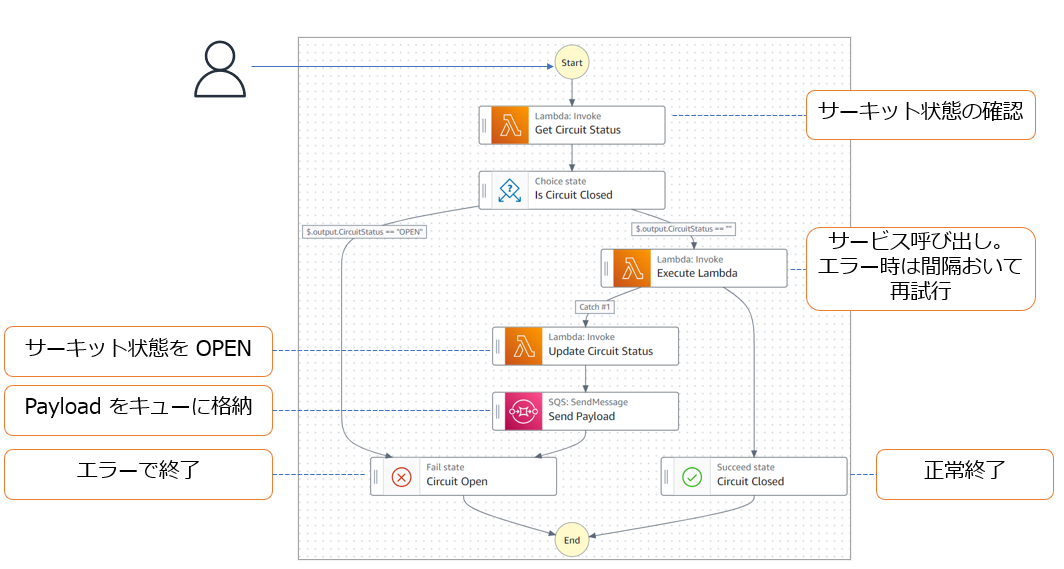
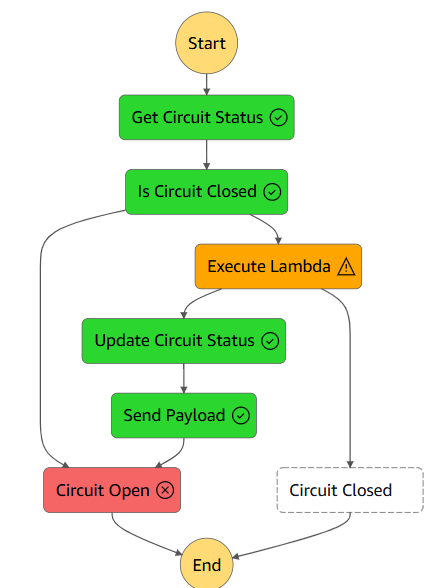
上記の点を踏まえて、自分なりに改良を加えることにしました。 またブログ記事では ステートマシンから呼び出す Lambda 関数のランタイムが .NET C# ですが、Python を使う人にも理解しやすいように、Lambda 関数のランタイムを Pythonで実装しなおしました。 そのステートマシンのイメージが下図です。Update Circuit Status ステートの後に Amazon SQS のキューに Payload を送信するステートを追加しました。これにより、呼び出しが失敗した場合でも、その Payload の消失を防げます。

実際のコードや AWS SAM リソースはこちらになります。(あくまで個人のコードでありサンプルとして公開しています。)

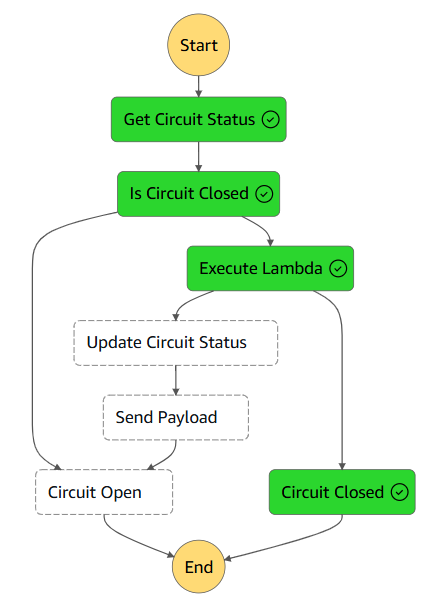
では実行してみましょう。まずは呼び出し先の Payment サービスに問題がなく、正常に呼び出せるケースを試してみます。

上の図のように、最初はサーキット状態はクローズで、実際に Payment サービスも問題なく呼び出せるので Succeed ステートである Circuit Closed で終了します。

次は、呼び出し先のサービスに問題があり、正常に呼び出せないケースです。 このケースでは、AWS Lambda 関数で必ずタイムアウトエラーが発生する PaymentTimeout というサービスを呼び出します。 すると、Execute Lambda ステートでエラーが発生しますが、リトライを設定しているので、何度かリトライを行います。 ただし、リトライをしてもエラーになるので、最終的には Fail ステートである Circuit Opened で終了します。

この時、Amazon DynamoDB テーブルへ下記の項目を Put します。

ServiceName
(Partition Key)
ExpireTimeStamp
(Sort Key)
CircuitStatus
Payment 現在のエポック秒へ 20 秒足した値 OPEN

またサービス呼び出し元から送信された Payload や Lambda 関数のエラーメッセージ(下記)を Amazon SQS のキューへ送信しています。

{
    "executionId": "arn:aws:states:ap-northeast-1:000000000000:execution:circuitbreaker-statemachine:5464ba09-3c01-4f8a-9da3-8007d67225ed",
    "state": {
        "TargetLambda": "arn:aws:lambda:ap-northeast-1:000000000000:function:circuitbreaker-PaymentTimeout",
        "Payload": {
            "order": {
                "item_id": "Dummy02",
                "unit": 20
            }
        },
        "output": {
            "TargetLambda": "arn:aws:lambda:ap-northeast-1:000000000000:function:circuitbreaker-PaymentTimeout",
            "CircuitStatus": ""
        },
        "taskresult": {
            "Error": "States.Timeout",
            "Cause": ""
        }
    }
}

これでサーキット状態が OPEN になりました。 この状態は DynamoDB テーブルへ保存していますが、有効期限を 20 秒に設定していますので、20 秒以内に同じリクエストを再送すると下図のようになります。

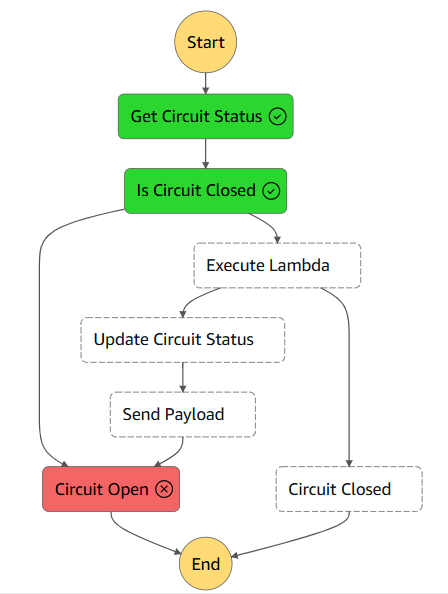
サーキット状態が OPEN であれば、サービスを呼び出さず、すぐに Fail ステートでステートマシンを終了させていますね。

もし、20秒以上経過してからリクエストを再送した場合は、DynamoDB テーブルの項目は有効期限が経過しているので削除されているか、もしくは項目が残っていても Query で ExpireTimeStamp >現在エポック秒 の条件を指定してサーキット状態を取得しているので、項目は取得されずサーキット状態は OPEN ではないものと判断され、もう一度 Execute Lambda ステートを実行します。

その他のサーキットブレーカーパターンの実装例

サーキットブレーカーパターンの実装は他にもあります。例えば下記のブログ記事では、AWS Step Functions ではなく、AWS Lambda extensions を使用しています。

aws.amazon.com

上記のブログ記事の実装例は、サービス呼び出しが同期呼び出しを前提としています。またサーキットブレーカーのロジックを呼び出し元のサービス内に埋め込む形となります。 呼び出すサービスの状態は Amazon DynamoDB のテーブルへ保存していますが、Extensions 側でキャッシュでも維持しているところが興味深いですね。 また、呼び出すサービスの状態を定期的にチェックするために、Amazon EventBridge やチェック用の Lambda 関数を別途用意している点も、AWS Step Functions を使用するパターンとは異なります。 これはこれで、一つの実装パターンですね。

最後に

この記事では AWS Step Functions をサーキットブレーカーパターンの実装に用いるトピックについて扱いましたが、AWS Step Functions は他にも様々な適用ができます。 例えば、AWS 規範ガイドにある Sage パターン (厳密にいうと Sage におけるオーケストレーションのパターン)でも AWS Step Functions を活用できます。

docs.aws.amazon.com

このパターンでも、AWS Step Functions を活用することで実装の容易性や可視性、トレース性を向上できているといえます。

このように、AWS Step Functions は様々なパターンの実装に適用できる「使いやすい」サービスだなと改めて感じました。

AWS Step Functions を活用した実装パターンについては、今後も探求し続けたいと思います!


/* -----codeの行番号----- */